Comment fonctionne un générateur d’images par IA
Vous tapez une phrase, quelques secondes plus tard une image apparaît. Derrière ce tour de passe-passe, il n'y a ni banque d'images ni collage. Il y a un modèle mathématique qui a appris à reconnaître des motifs.
Un générateur d'images par IA apprend, à partir de très nombreuses images légendées, à retirer du bruit visuel pas à pas. Votre texte guide ce nettoyage. Le modèle part d'un bruit aléatoire et le transforme en image cohérente avec votre description. Cet article détaille l'entraînement, la lecture du texte et la génération.
Ce que le modèle apprend pendant l'entraînement
Un générateur n'est pas programmé avec des règles du type « un chat a quatre pattes ». Il est entraîné sur un immense corpus de paires composées d'une image et de sa légende. À force d'exemples, il repère des régularités statistiques: formes, textures, styles, associations entre mots et apparences.
Le principe du bruit
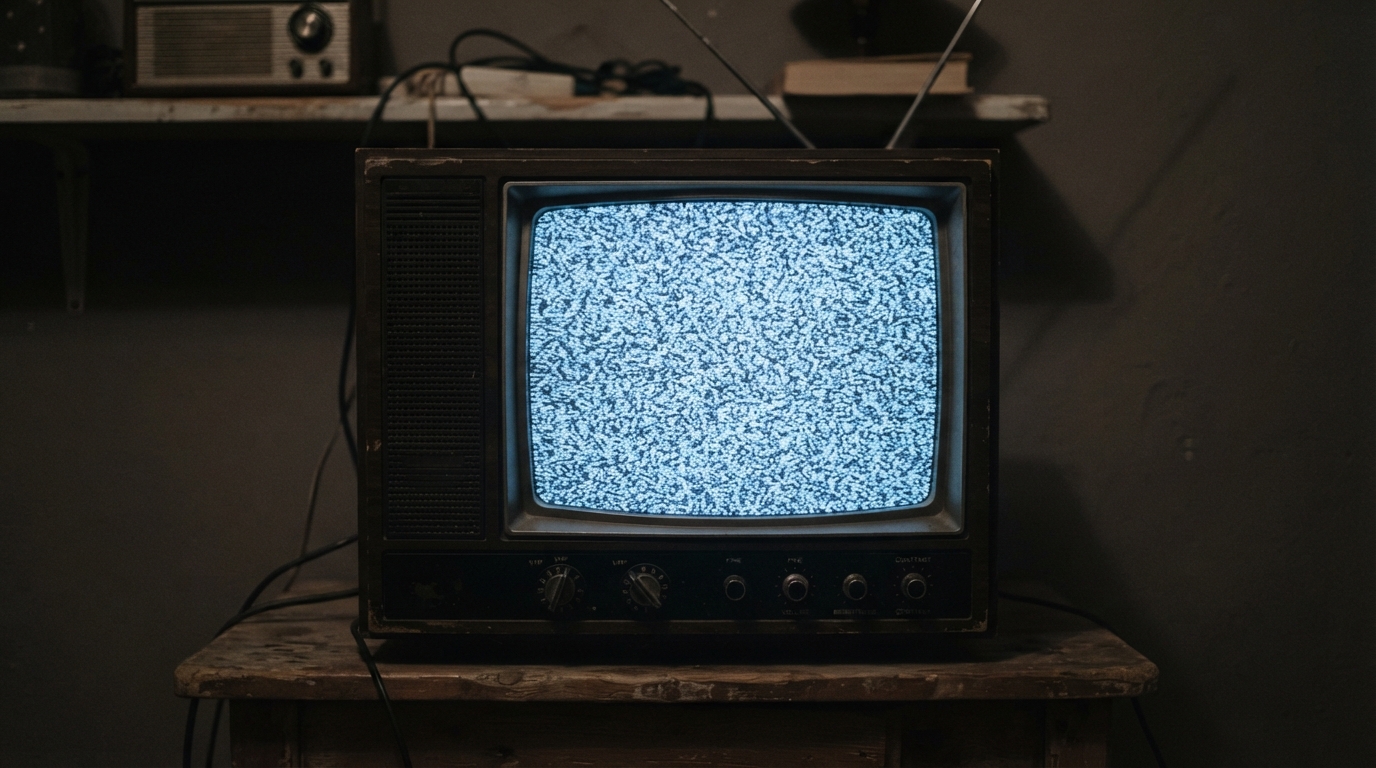
La plupart des outils grand public reposent sur des modèles dits de diffusion. Pendant l'entraînement, on prend une image réelle et on la dégrade progressivement en y ajoutant du bruit, c'est-à-dire des pixels aléatoires, comme la neige d'un vieux téléviseur. Jusqu'à ce qu'il ne reste plus rien de reconnaissable.
Le modèle doit ensuite faire le chemin inverse. À chaque étape, il prédit quel bruit a été ajouté pour pouvoir le retirer. Répété des millions de fois, cet exercice lui apprend à reconstruire une image plausible à partir du chaos.
Le saviez-vous ? Les modèles de diffusion ne sont pas la seule famille de générateurs. Les réseaux antagonistes génératifs (GAN) ont précédé cette approche, avec deux réseaux qui se font concurrence, l'un créant, l'autre jugeant. Les modèles de diffusion dominent aujourd'hui les outils grand public.
Comment votre texte devient une image
Le modèle de diffusion ne comprend pas les mots. Il faut donc traduire votre phrase en nombres. C'est le rôle d'un encodeur de texte, qui convertit chaque mot ou fragment de mot en une suite de valeurs appelée vecteur.
Ces vecteurs placent les concepts dans un espace où les idées proches se retrouvent proches. « Chien » et « chiot » s'y côtoient, « chien » et « cathédrale » beaucoup moins. Ce même espace relie le texte aux images, grâce à l'entraînement sur des paires image-légende.
Le rôle du prompt
Votre description, le « prompt », sert de boussole à chaque étape de nettoyage. Le modèle ne se contente pas de retirer du bruit, il le retire dans la direction qui rapproche le résultat de votre texte. Plus la description est précise, plus la boussole est nette.
Un réglage souvent proposé, appelé échelle de guidage, mesure l'obéissance au texte. Trop faible, l'image s'éloigne de votre demande. Trop forte, elle devient rigide et parfois artificielle.
La génération, étape par étape
Voici ce qui se passe quand vous validez votre prompt. Le déroulé varie selon les outils, mais la logique reste la même. Les étapes suivantes en donnent le schéma général.
- Votre texte est converti en vecteurs par l'encodeur.
- Le système tire un bruit aléatoire, point de départ de l'image.
- Le modèle retire le bruit en plusieurs passes, en suivant le texte.
- L'image finale est reconstruite en pleine résolution et vous est présentée.
Pourquoi deux demandes identiques donnent deux images différentes
Le point de départ est un bruit tiré au hasard. Un autre bruit mène donc à une autre image, même avec le même texte. Beaucoup d'outils proposent de fixer cette « graine » (seed en anglais) pour retrouver un résultat identique ou le faire varier légèrement.
Bon à savoir : pour gagner du temps, de nombreux modèles ne travaillent pas directement sur les pixels. Ils opèrent dans une version compressée de l'image, l'espace latent, puis la décompressent à la fin. C'est ce qui rend la génération assez légère pour tourner sur du matériel grand public.
Pourquoi les erreurs persistent
Le modèle imite des régularités, il ne comprend pas la physique ni l'anatomie. D'où des défauts connus: mains aux doigts mal comptés, texte illisible dans l'image, objets fusionnés, reflets incohérents. Les versions récentes progressent sur ces points, mais aucun outil ne les a fait disparaître totalement.
Ces ratés ont une cause simple. Un doigt est un détail minuscule, qui apparaît sous mille angles dans les données. Le modèle apprend une moyenne plausible, pas une règle de construction.
Les erreurs fréquentes des utilisateurs
Le résultat dépend aussi de la façon de demander. Voici les pièges les plus courants, utiles à connaître avant de blâmer l'outil.
- Un prompt trop vague, qui laisse le modèle choisir à votre place.
- Un prompt surchargé, où des consignes se contredisent.
- Une demande de texte précis dans l'image, que les modèles gèrent encore inégalement.
- L'absence de précision sur le style, la lumière ou le cadrage.
Un prompt efficace décrit le sujet, le décor, la lumière et le style, sans empiler vingt adjectifs. Procédez par petites retouches plutôt que par réécriture complète.
Données d'entraînement, droits et limites
Les images produites ne sont pas des copies de fichiers stockés. Le modèle conserve des paramètres numériques, pas une galerie. Il arrive pourtant qu'il reproduise des éléments très présents dans ses données, comme un style reconnaissable ou un motif récurrent.
Reste la question des droits sur les œuvres utilisées à l'entraînement et sur les images produites. Elle dépend des pays, des outils et de leurs conditions d'utilisation. Avant tout usage commercial, lisez les conditions du service que vous utilisez.
Bon à savoir : de nombreux services ajoutent des métadonnées ou des marquages signalant qu'une image est générée par IA. Leur présence varie selon les outils, et un simple recadrage ou une capture d'écran peut les faire disparaître.
Ce que cela change pour la création
Ces outils conviennent bien à l'exploration: tester une ambiance, préparer une planche d'inspiration, illustrer une idée avant de la confier à un artiste. Ils conviennent moins quand il faut une précision absolue, un personnage identique d'une image à l'autre ou un texte parfaitement rendu.
Notre avis tient en une phrase: considérez le générateur comme un crayon très rapide mais distrait. Il vous fait gagner du temps sur l'ébauche, pas sur le jugement. Savoir regarder une image reste la compétence décisive, et notre méthode pour lire un tableau au musée vous y aidera aussi face à une image générée.
Conclusion
Comprendre comment fonctionne un générateur d'images par IA suffit à mieux s'en servir. Le modèle part d'un bruit, le nettoie pas à pas, guidé par vos mots traduits en nombres. Il imite des régularités apprises, ce qui explique à la fois sa créativité apparente et ses erreurs. Soignez votre description, variez la graine, corrigez par touches successives.
FAQ
Un générateur d'images par IA copie-t-il des images existantes ?
Non, il ne pioche pas dans une banque d'images. Il produit une image nouvelle à partir de ce qu'il a appris. Il peut néanmoins reproduire des motifs ou styles très présents dans ses données d'entraînement.
Pourquoi mes images changent-elles à chaque essai ?
Chaque génération démarre d'un bruit aléatoire différent. Si l'outil permet de fixer la graine, vous retrouvez un résultat proche d'un essai à l'autre.
Faut-il écrire des prompts très longs ?
Non. Un prompt clair décrivant sujet, décor, lumière et style vaut mieux qu'une accumulation de mots. Affinez ensuite par petites modifications.
Pourquoi les mains et les textes sont-ils souvent ratés ?
Le modèle apprend des ressemblances statistiques, pas des règles d'anatomie ou d'écriture. Les détails fins et variables sont donc plus fragiles. Les versions récentes s'améliorent, sans garantie.
Peut-on utiliser ces images librement ?
Cela dépend de l'outil et de ses conditions d'utilisation, ainsi que du droit applicable. Vérifiez les règles du service avant un usage commercial.